











一个数据库管理器,第一次部署成功并不难。更能检验这套部署是否可靠的,是三个月以后:VPS 要迁移,镜像要升级,或者重建容器后用户突然不见了。此时手里若只有一句 docker run,就很难知道丢的是配置、工作区,还是接错了数据卷。
CloudBeaver Community 适合放在 VPS 上长期作为浏览器数据库入口,但它自己也有状态。本文围绕一件事展开:怎样让这套入口能够备份、恢复和升级,而不是只能在最初那台机器上运行。示例固定为 26.2.1,采用单实例、持久卷和宿主机 Caddy。
先把“数据”分成三份
第一份是程序与部署参数:镜像版本、Compose、JVM 设置、端口、代理配置。它决定服务怎样启动。
第二份是 CloudBeaver 自己的工作区和系统状态:用户、连接、权限以及相关配置。官方当前文档说明,Community 仍使用 H2 作为内部数据库;商业版文档中出现的 PostgreSQL 服务端数据库,不应直接套用到社区版上。这个内部数据库也不是你通过界面连接的业务 PostgreSQL。Server database 说明
第三份才是业务数据,例如网站订单库、博客库、分析库。CloudBeaver 能访问它们,但管理器工作区的备份并不会把这些数据库一并备份下来。
| 你希望恢复的东西 | 应保存的材料 | 单靠什么不够 |
|---|---|---|
| 把服务重新启动 | Compose、镜像版本或摘要、代理配置 | 一张容器运行截图 |
| 找回用户与连接 | 一致的完整工作区、必要的外部配置与密钥材料 | 仅复制一个连接 JSON |
| 找回误删的业务记录 | 业务数据库自身的备份与恢复链 | CloudBeaver 工作区压缩包 |
先做这个区分,备份任务才不会看似每天成功,出事时却发现保存错了对象。
为长期维护留一份简单的 Compose
Docker 与 Compose 插件已经安装的 VPS,可以使用下面的配置。与匿名临时卷相比,显式卷名更便于备份脚本核对目标:
name: cloudbeaver
services:
  cloudbeaver:
    image: dbeaver/cloudbeaver:26.2.1
    restart: unless-stopped
    ports:
      - "127.0.0.1:8978:8978"
    volumes:
      - workspace:/opt/cloudbeaver/workspace
    environment:
      JAVA_OPTS: "-Xms256m -Xmx1024m"
    mem_limit: 2g
    logging:
      driver: json-file
      options:
        max-size: "10m"
        max-file: "3"
volumes:
  workspace:
    name: cloudbeaver_workspace
第一次运行之前确认这个卷名没有被别的部署占用。计划在同一台机器放多个实例时,每套都要使用自己的项目名、端口和卷名,不能只改容器名。
docker compose config --quiet
docker compose pull
docker compose up -d
docker compose logs --tail=100 cloudbeaver
先通过 ssh -N -L 18978:127.0.0.1:8978 your-user@your-vps 在本机浏览器完成管理员设置,关闭匿名入口。需要固定域名时,让宿主机 Caddy 把自己的 HTTPS 域名代理到 127.0.0.1:8978。这两种访问方式都不要求把 8978 直接开放给公网。
2GB 容器上限和 1GB Java 最大堆只是小规模起点。堆外内存、驱动、结果集和其他同机服务都要算进去。升级前如果机器已经频繁换页或发生 OOM,应先处理容量问题,否则新版本很容易替旧问题背锅。
选新节点时,可以把雨云的云服务器方案放进候选清单。这里更值得比较的是长期配置和恢复条件:是否有足够磁盘保存备份、是否方便扩容、到数据库的网络是否稳定。快照可以提供额外保护,但不要把厂商快照当成已经做过应用恢复演练。
给版本留一个能找回的名字
latest 使用方便,却不适合用来描述一次可以复现的生产发布。至少记录版本标签,再保存实际镜像摘要:
docker image inspect dbeaver/cloudbeaver:26.2.1 \
  --format '{{index .RepoDigests 0}}'
docker compose images
这里输出的是你实际拉取到的镜像信息,不要复制别人文章里的某串摘要,默认它适用于自己的环境。需要严格固定时,可把 Compose 的 image 改为经过核实的 dbeaver/cloudbeaver@sha256:...;省略号必须替换成真实完整值。
同时记录 CPU 架构、Compose 文件和自定义驱动。更换 VPS 时,x86 与 ARM 的镜像可用性、额外驱动和本地依赖都应重新检查。留一个标签并不等于已经验证跨架构迁移。
小实例备份,宁可短暂停一下
社区版单实例的一个易理解做法,是安排短维护窗口,正常停止 CloudBeaver 后再复制完整工作区。这样不需要把正在写入的 H2 文件当作普通静态文件直接打包。业务数据库不会因为停止这个管理入口就随之停止,但使用者的连接和未完成工作会受影响,应提前结束查询与事务。
以下脚本在保存 Compose 的目录运行,使用上面明确声明的 cloudbeaver_workspace。执行前确认卷名和服务名,备份目录不应处于网站公开目录中:
#!/usr/bin/env bash
set -euo pipefail
umask 077

backup_dir="$PWD/backups/$(date -u +%Y%m%dT%H%M%SZ)"
mkdir -p "$backup_dir"
cp compose.yaml "$backup_dir/compose.yaml"
docker image inspect dbeaver/cloudbeaver:26.2.1 \
  --format '{{index .RepoDigests 0}}' > "$backup_dir/image.txt"

# 先确认卷存在,避免拼错名字时创建一个空卷。
docker volume inspect cloudbeaver_workspace >/dev/null
trap 'docker compose start cloudbeaver' EXIT
docker compose stop -t 60 cloudbeaver

docker run --rm --user 0 --entrypoint sh \
  --mount type=volume,src=cloudbeaver_workspace,dst=/source,readonly \
  --mount type=bind,src="$backup_dir",dst=/backup \
  dbeaver/cloudbeaver:26.2.1 \
  -c 'tar -czf /backup/workspace.tgz -C /source .'

sudo chown "$(id -u):$(id -g)" "$backup_dir/workspace.tgz"
chmod 600 "$backup_dir/workspace.tgz"
tar -tzf "$backup_dir/workspace.tgz" >/dev/null
sha256sum "$backup_dir/workspace.tgz" > "$backup_dir/workspace.sha256"
脚本退出时会尝试启动服务,但这不等于启动必然成功。完成后仍需检查 docker compose ps、启动日志和实际登录。若停止阶段超时、进程被强杀或压缩失败,要处理异常,不能只看目录里是否出现了一个文件。
这里用同版本镜像里的 tar 读取卷,备份时不运行第二个 CloudBeaver 实例。卷只读挂载,也不会启动第二个进程争抢工作区。保留目录中的点文件和原有权限信息;不要只挑出看起来熟悉的几个 JSON 文件。
工作区可能含有凭据材料。打包以后应按你的备份制度加密,传到另一台机器或其他独立存储,并限制读取者。磁盘还在同一台 VPS 上的“备份”,无法解决整机或账号一起失去的情况。加密文件对应的解密材料也要能在故障时取得,不能只留在原机。
恢复演练,用新卷,不覆盖旧卷
恢复前先核对压缩包来源和校验值,只处理自己可信的备份。演练应使用独立目录、不同端口和一个确认未被使用的新卷名:
docker volume create cloudbeaver_restore_20260930

docker run --rm --user 0 --entrypoint sh \
  --mount type=volume,src=cloudbeaver_restore_20260930,dst=/restore \
  --mount type=bind,src="$PWD/backups/你的备份目录",dst=/backup,readonly \
  dbeaver/cloudbeaver:26.2.1 \
  -c 'tar -xzf /backup/workspace.tgz -C /restore'
先把“你的备份目录”替换成实际绝对目录,并确认新卷为空。恢复到新卷后,复制一份 Compose:项目名改成 cloudbeaver-restore,宿主机端口改成 127.0.0.1:18979:8978,底部卷名改成 cloudbeaver_restore_20260930。第一次先使用备份时的同一镜像版本启动。
不要把正式域名指向演练实例,也不要让两个实例同时写同一工作区。演练环境还应限制到生产数据库的网络访问;恢复的连接定义可能仍指向真实生产库,不能因为网页标题写着“测试”就认为它已经隔离。
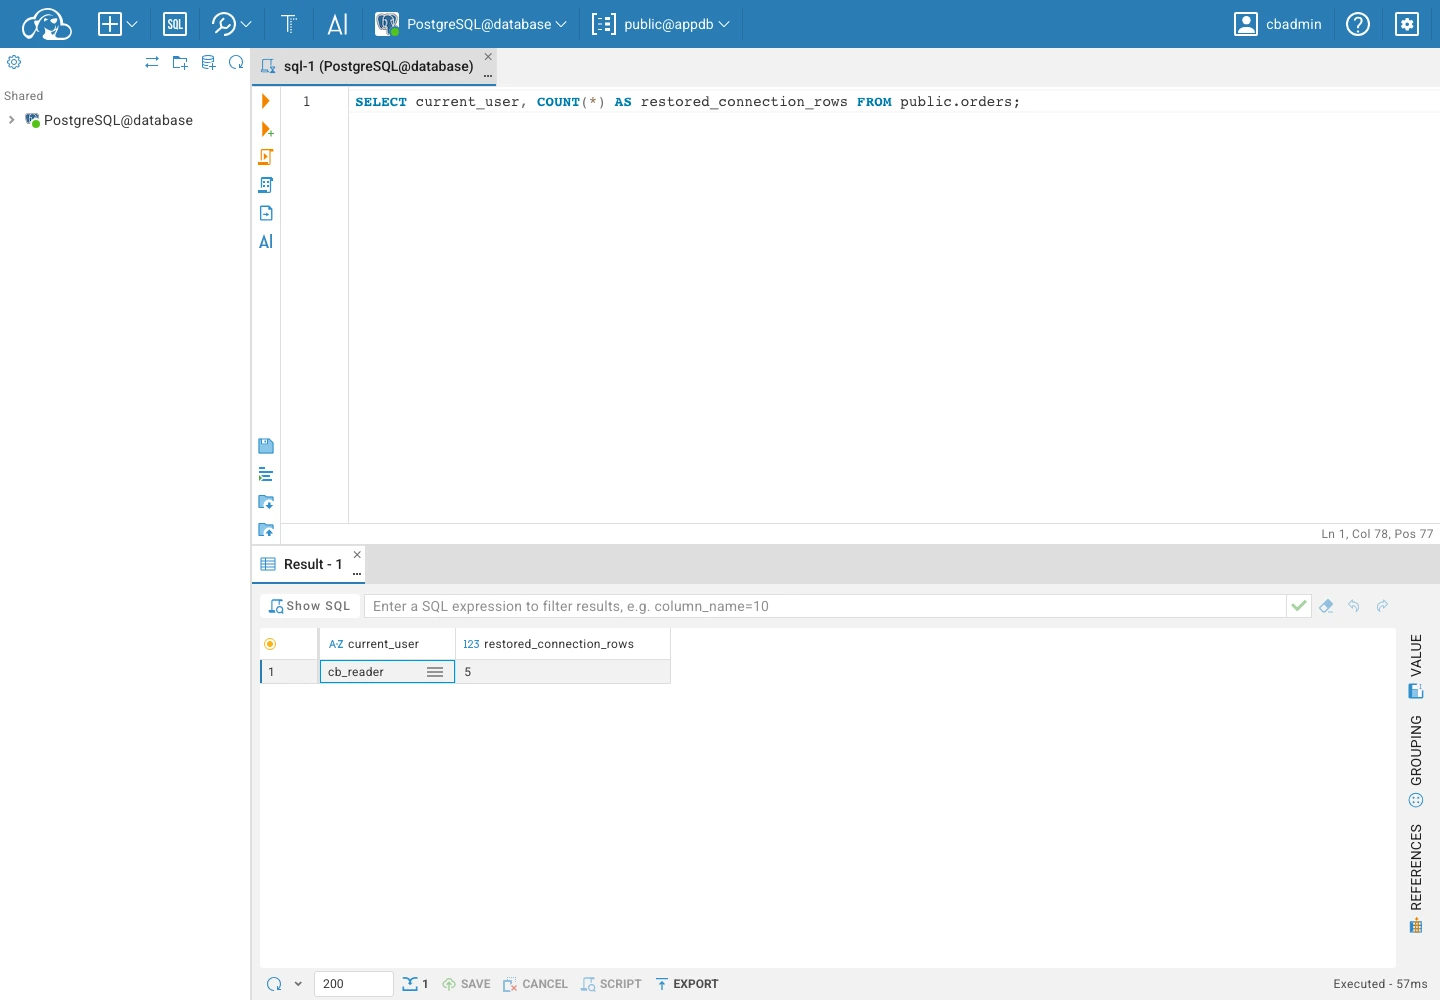
恢复检查应使用演练连接和虚构数据。界面能打开只是第一步,还要确认用户、连接和权限。
登录原来的管理员账号,检查普通用户、团队、连接名称和关键设置是否存在。接着用受限演练连接跑一个小查询,确认驱动也能使用。最后退出重登,重启一次演练容器,再重复检查。到了这一步,才能把“备份文件存在”改成“这份备份能恢复”。
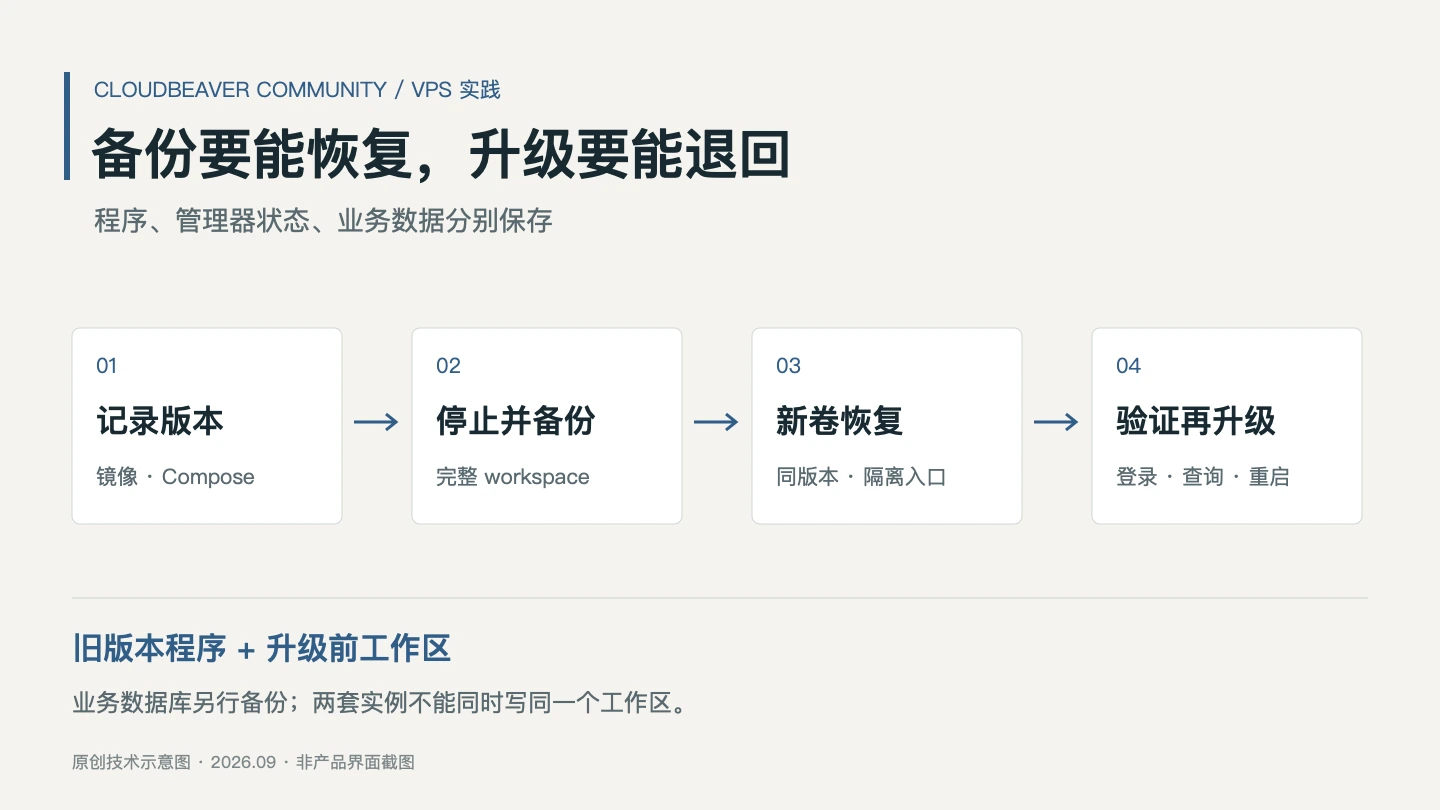
升级之前,先在副本上过一遍
先读目标版本的发行说明,尤其是认证、驱动、内部数据结构和安全修复。不要只看界面新增了什么。26.2.1 的官方变更记录就包含配置阶段访问限制等安全修复,说明管理入口本身也需要持续更新。项目发行说明
可行的顺序是:备份当前状态,恢复到隔离副本,在副本上更换目标镜像,再验证登录、连接、查询、导出和重启。测试通过以后,才安排正式维护窗口,重新备份正式工作区并执行切换。
更新时保留旧镜像和升级前备份。如果新版本已经迁移了内部状态,简单把 image 改回旧版本,不一定能读懂新的工作区。可靠的回退通常需要“旧版本程序+升级前状态”这一对,而不是只有旧程序。升级窗口内发生的新设置变更,也要考虑如何保留或重新执行。
版本回退不是数据库业务回退。CloudBeaver 升级后有人修改了业务数据,恢复管理器旧工作区不会撤销那些 SQL。需要把应用状态变更和业务数据变更分别追踪。
日常看三类信号,别只盯容器是否在运行
第一类是入口是否可用:域名、证书、登录页和代理上游。第二类是应用是否稳定:重启次数、内存、磁盘和异常日志。第三类是实际工作能否完成:一条受限测试连接是否成功,简单查询是否在预期时间内返回。
docker compose ps
docker stats --no-stream
cid=$(docker compose ps -q cloudbeaver)
docker inspect "$cid" --format '{{.RestartCount}} {{.State.OOMKilled}}'
docker compose logs --since=30m cloudbeaver
df -h
OOMKilled=false 只描述当前容器状态,不是过去从未缺过内存的证明。频繁重启还要结合日志、宿主机记录和监控时间线看。需要增加 Java 堆时,也同时检查容器上限和主机余量。
查询日志和导出文件可能含业务信息,转发到工单以前先脱敏。日志轮转只解决容量问题,不解决谁能读取的问题。导出文件的保留期限也应有安排,不要让管理器慢慢变成没人清理的数据仓库。
从旧 VPS 搬到新 VPS
迁移之前,在新节点验证目标数据库来源规则、DNS、TLS 和驱动下载条件。旧节点能连,不代表新节点的出口地址自动被允许。使用新源地址时,先用受限账号验证,不要为赶进度放开整个公网。
正式迁移时暂停管理器写入,制作最后一份工作区备份,恢复到新机,再通过临时 SSH 隧道验收。确认完成后才切换域名,并保留一段可回退窗口。窗口内避免两边同时使用,防止用户在不同实例改出两份配置。
如果还要同步迁移业务数据库,那是另一项迁移工作,需要自己的数据一致性、停写和恢复计划,不能顺手塞进“复制 CloudBeaver 目录”这一步。
验证记录与使用边界
本文在本机 ARM64 隔离 Docker 环境验证了 CloudBeaver Community 26.2.1:完成初始化和管理员登录,通过浏览器连接 PostgreSQL 18.6 并查询五条虚构订单;数据库侧验证只读角色可查询、更新被拒绝。停止实例后备份工作区,恢复到独立卷和另一端口,再用原账号登录并通过原连接查询成功。四份 Compose 示例均通过配置校验。导入导出步骤依据官方文档整理,未做生产数据迁移、跨版本升级或 VPS 机房性能测试。
本文的停机打包和独立卷恢复针对单实例社区版。使用外部状态存储、自定义密钥服务、额外挂载或商业版部署时,应把那些依赖一起纳入备份清单。备份成功之后,最值得保留的不是一句“已完成”,而是恢复时用过的版本、卷名、校验值和检查结果。下一次真正需要它们时,就不用靠回忆拼出整套部署。