











数据库入口集中以后,最容易发生的一件事,是大家都用同一条连接。连接里保存了一个权限很高的账号,谁登录网页都能查,也都能改。刚开始很方便,直到某次有人把测试语句跑到了生产库,才发现“每个人有自己的登录名”并没有解决数据库授权问题。
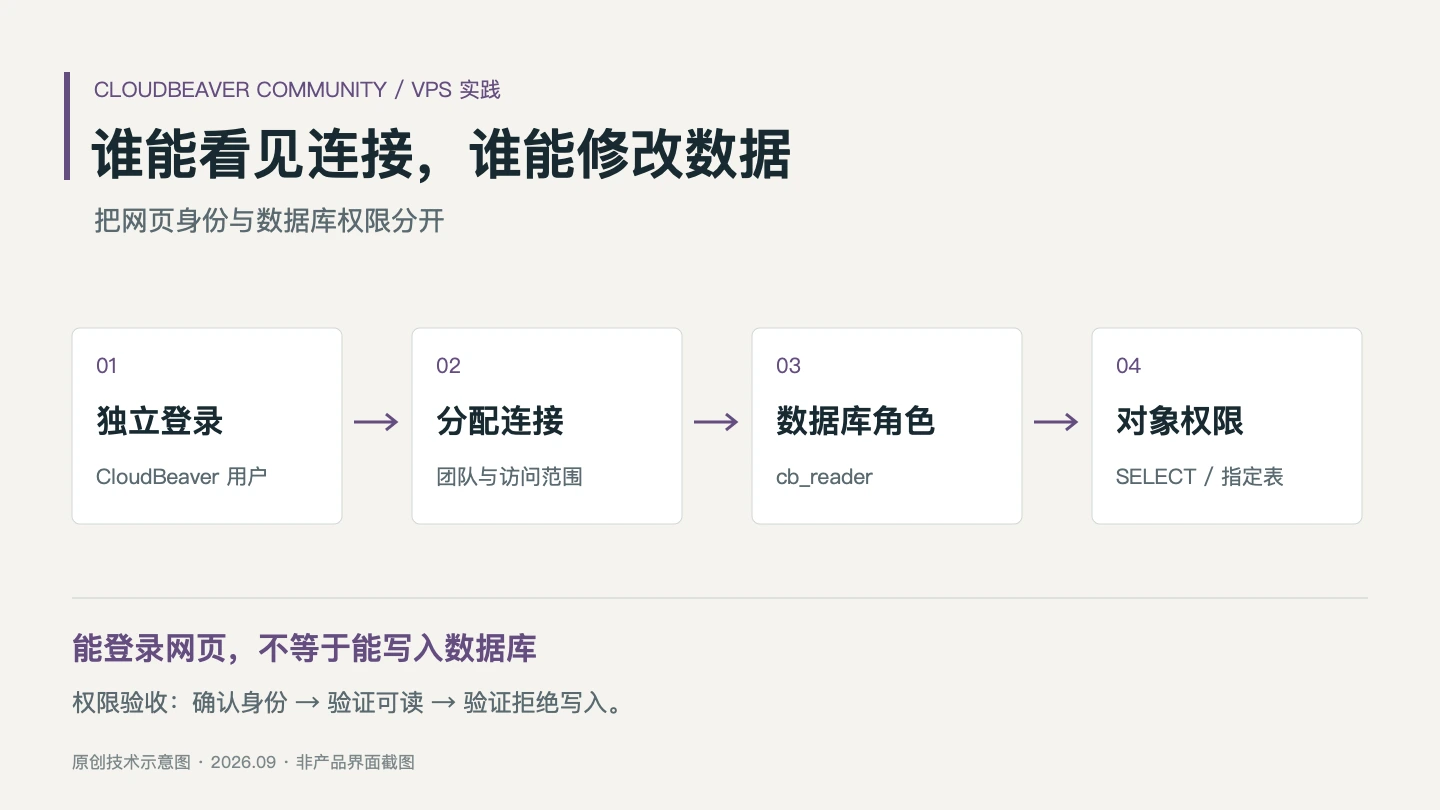
CloudBeaver 放在 VPS 上,值得花时间设计的就是这条权限链:谁能访问网页,谁能看见连接,连接使用哪个数据库账号,这个账号又能执行什么。本文以 Community 26.2.1 和 PostgreSQL 为例,把一个面向小团队的只读入口拆开搭好。
先给三种账号各找一个位置
VPS 的 SSH 用户管理服务器,CloudBeaver 用户登录网页,PostgreSQL 角色访问数据库。三个层级可以由同一个人使用,但不该混成同一份权限。
| 身份 | 应当负责的事情 | 不应顺手得到的权限 |
|---|---|---|
| VPS 运维用户 | 更新容器、备份工作区、查看日志 | 把 SSH 私钥发给所有数据使用者 |
| CloudBeaver 管理员 | 建用户、配置连接、分配访问 | 日常查表都用这个账号 |
| 普通 CloudBeaver 用户 | 使用被分配的连接 | 默认看见所有生产库 |
| PostgreSQL 只读角色 | 读取指定数据库、Schema 或表 | 超级用户、对象所有权、任意写入 |
CloudBeaver 的本地用户和团队管理负责前两道门;数据库权限才决定 SQL 最终能做什么。界面里隐藏一个编辑按钮,不能替代 PostgreSQL 的授权。CloudBeaver 用户管理
“协作”也要说具体。多人可以通过统一入口处理各自的查询,但不能因此假定两个人同时修改同一行时,会获得文档式的实时合并。锁、事务隔离和并发更新仍由数据库处理,业务冲突仍需要应用或工作流程解决。
先把入口收窄,再创建团队
一台 VPS 上运行社区版,可以采用下面这份起步配置。它假设 Caddy 在宿主机,Docker 与 Compose 插件已经装好:
name: cloudbeaver
services:
  cloudbeaver:
    image: dbeaver/cloudbeaver:26.2.1
    restart: unless-stopped
    ports:
      - "127.0.0.1:8978:8978"
    volumes:
      - workspace:/opt/cloudbeaver/workspace
    environment:
      JAVA_OPTS: "-Xms256m -Xmx1024m"
    mem_limit: 2g
    logging:
      driver: json-file
      options:
        max-size: "10m"
        max-file: "3"
volumes:
  workspace:
执行 docker compose config --quiet 检查后,再 docker compose up -d。首次设置通过 SSH 隧道完成,避免把未初始化的管理器先交给公网:
ssh -N -L 18978:127.0.0.1:8978 your-user@your-vps
本机访问 http://127.0.0.1:18978/,创建管理员,关闭匿名访问,确认工作区会持久保存。若只是自己偶尔查库,保留 SSH 隧道这个使用方式就够了,不一定非要做公网域名。
确实需要团队浏览器访问时,增加 HTTPS 入口:
db.example.com {
    reverse_proxy 127.0.0.1:8978
}
修改自己的域名并校验 Caddy 配置,再重新加载。数据库的 5432 不需要因为有了网页入口而向全网开放;允许 CloudBeaver 所在主机或专用网络访问即可。容器端口绑定和云安全组是不同位置的控制,检查时两处都要看。
如果正在选 VPS,可以把雨云的云服务器方案作为一个候选。对数据库管理器来说,优先级通常是机房与数据库之间的网络、可用内存、备份空间,然后才是活动价。已有服务器能满足这些条件,就没有必要为了安装一个入口再买一台。
PostgreSQL:先做一个范围明确的只读账号
下面使用三个示例名:数据库 appdb、Schema public、只读角色 cb_reader。它们都应替换成你的实际名称。先在有建角色权限的管理会话中执行:
CREATE ROLE cb_reader LOGIN;
GRANT CONNECT ON DATABASE appdb TO cb_reader;
在 psql 中使用交互命令设置密码,避免把真实密码写进教程、工单或普通 SQL 文件:
\password cb_reader
\connect appdb
进入目标库后,再授予对象权限:
GRANT USAGE ON SCHEMA public TO cb_reader;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO cb_reader;
这组授权的范围是目标 Schema 中的现有表和视图。只需读两张表时,就把 ALL TABLES 改成明确的表名;如果其中包含敏感信息,应先考虑专门的脱敏视图,而不是把整个 public 都交出去。PostgreSQL GRANT 文档
新建表还需要另外安排。假设业务迁移由 app_owner 创建对象:
ALTER DEFAULT PRIVILEGES FOR ROLE app_owner IN SCHEMA public
GRANT SELECT ON TABLES TO cb_reader;
这条语句要在 appdb 中,由有权修改 app_owner 默认权限的账号执行。它只影响这个创建者以后创建的对象,不会补齐旧表,也不会自动覆盖另一位创建者。数据库里有多个迁移账号时,需要分别核实。默认权限说明
不要为了“彻底只读”,对既有生产库执行未经评估的全局 REVOKE ... FROM PUBLIC。这可能影响应用现有行为。先使用一个没有额外角色成员关系的新账号,再检查它继承到的权限;共享角色、公开权限和对象所有者身份,都可能扩大访问范围。
还要留意允许普通用户调用的函数。仅给表的 SELECT 权限,不等于在所有数据库设计下都获得绝对无副作用的沙箱。存在 SECURITY DEFINER 函数、扩展或其他可调用操作时,需要结合数据库本身审核。给查询入口配置只读副本,在一些场景下比不断修补生产库权限更直接。
用可验证的结果判断权限是否正确
打开 CloudBeaver 新建 PostgreSQL 连接,填写从 VPS 可以到达的地址,使用 cb_reader,先确认身份:
SELECT current_database(), current_user, session_user;
SELECT rolname, rolsuper, rolcreaterole, rolcreatedb
FROM pg_roles
WHERE rolname = current_user;
下面的示例假设演练库有一张 public.orders 表:
SELECT has_table_privilege(current_user, 'public.orders', 'SELECT') AS can_read,
       has_table_privilege(current_user, 'public.orders', 'UPDATE') AS can_update;
SELECT id, status FROM public.orders ORDER BY id LIMIT 20;
预期是能读,不能更新。进一步的“拒绝写入”测试应在演练库做,使用无业务影响的样例表:
BEGIN;
UPDATE public.orders SET status = status WHERE false;
ROLLBACK;
即使没有匹配行,数据库仍会检查更新权限。只读角色应被拒绝;如果没有拒绝,就回头查角色成员关系和对象授权。不要在生产表上随意测试这种语句,表级触发器等机制可能让“零行更新”也产生额外影响。
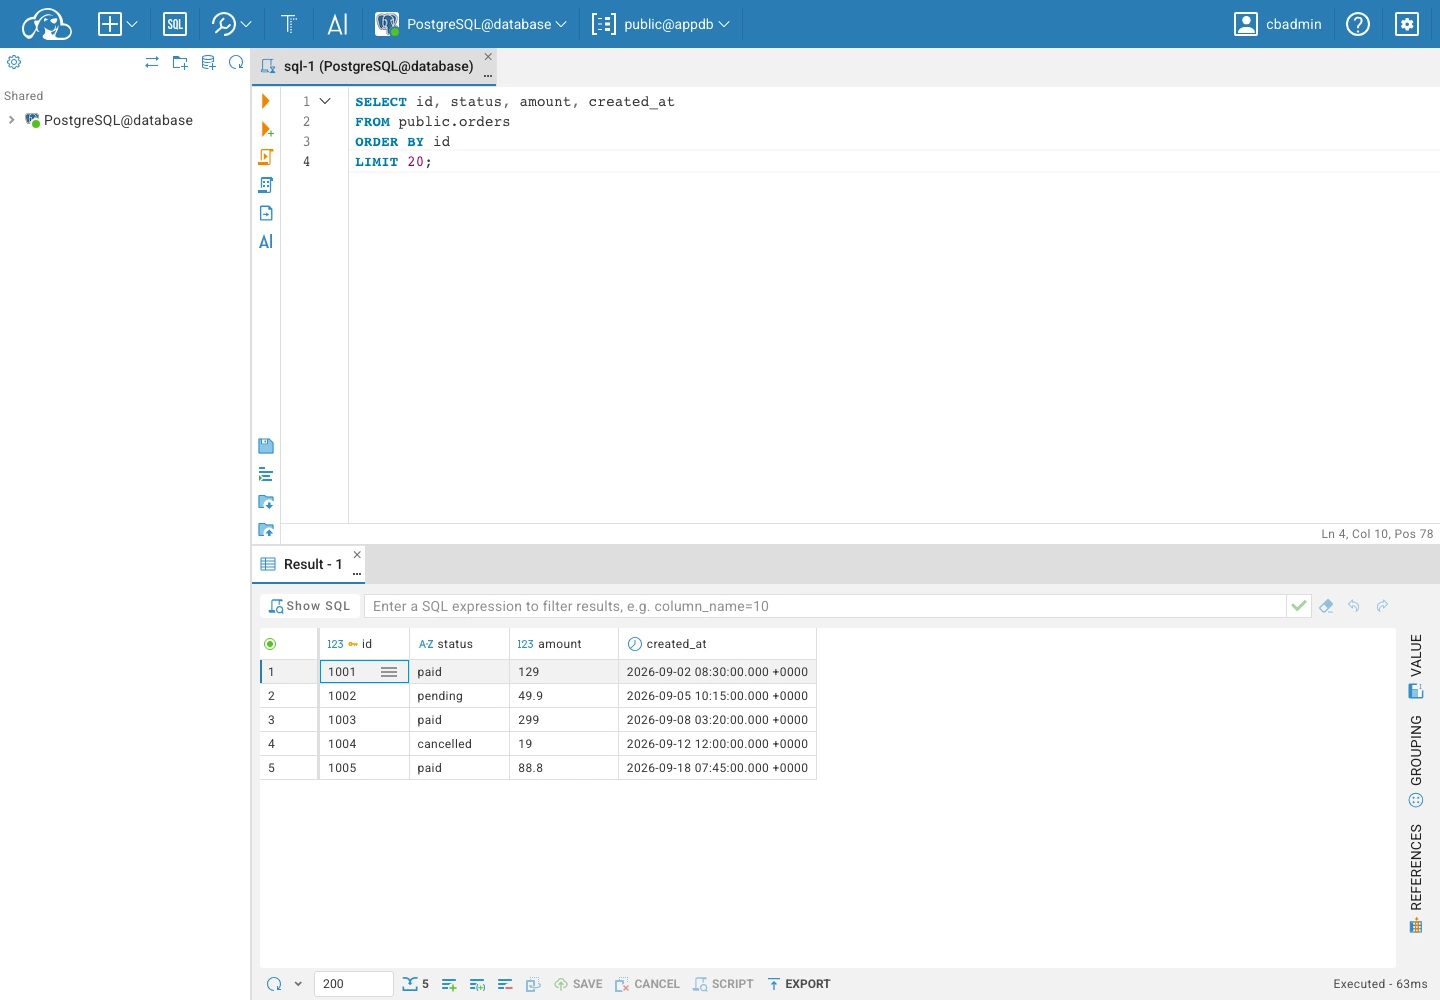
演示使用独立数据库,不包含真实订单、客户资料或生产凭据。
验证权限不必每次都从头猜。保存一组只读检查语句,每次新增成员、修改团队或更换连接账号后运行一遍,就能及时发现“本来只能看,后来却能改”的变化。
在 CloudBeaver 中分配连接
创建独立的普通用户,把只读成员放入同一个用途明确的团队,例如 report_readers。管理员建立连接后,只向这个团队分配连接访问权,再用普通账号实际登录确认:能看到预期连接,看不到无关生产库,查询身份也确实是只读角色。
连接保存凭据的方式需要事先决定。统一保存一个数据库账号,成员使用起来简单,但数据库日志往往只能看到这个共享账号。让成员使用各自数据库凭据,身份区分更直接,不过账号生命周期和支持成本也会增加。不要在文章里把“共享连接”写成“自动拥有完善的个人审计”。
需要严格追踪每个人执行了什么,就要进一步核对当前版本的审计能力,并结合数据库端日志设计。官方 Query Manager 文档标明它属于商业版本,不应该拿它替社区版部署作保证。Query Manager 版本说明
预配置文件里也可能含有敏感信息。官方连接配置文档指出,预填凭据在首次连接处理之前可能以明文存在。不要将包含密码的 data-sources.json 放进公开仓库;配置包、工作区和备份文件都应按凭据材料保护。预配置数据库连接
HTTPS 代理不等于“信任任意登录头”
普通 Caddy 转发不需要开启 CloudBeaver 的反向代理头认证。只有接入可信身份网关,并明确设计了认证头的生成、覆盖和信任范围时,才考虑这一模式。
它危险的地方在于:如果浏览器可以绕过代理直接访问后端,或者客户端自己发送的身份头没有被清除,就可能冒充其他用户。官方要求限制后端入口,并清除或覆盖来自客户端的身份头。不要看到网上一段 X-User 示例,就把它粘进公网配置。反向代理头认证说明
同样,浏览器到 Caddy 的 HTTPS,只保护了这段链路。CloudBeaver 到远端数据库如果穿过不可信网络,还需要数据库 TLS、可信 CA 和适当的服务端身份验证。遇到证书错误应检查主机名与证书链,不能把“关闭验证后能连”当成配置完成。
成员离开时,回收的是一整条访问链
删除网页账号之前,先弄清是否存在共享密码、外部数据库账号、导出的数据文件和其他直连入口。停用 CloudBeaver 用户,不会自动撤销他此前拿到的数据库密码;数据库侧有独立账号,就应按组织流程撤销或停用。共享凭据已经泄露给成员的,还要评估轮换。
日常也要区分“允许读取”和“允许带走”。用户能查询的数据,可能通过复制、导出或截图离开系统。对导出功能的限制只能减少某些路径,不能把可见数据变成不可复制的数据。敏感信息应尽量从查询对象本身缩小范围。
本文的验证范围
本文在本机 ARM64 隔离 Docker 环境验证了 CloudBeaver Community 26.2.1:完成初始化和管理员登录,通过浏览器连接 PostgreSQL 18.6 并查询五条虚构订单;数据库侧验证只读角色可查询、更新被拒绝。停止实例后备份工作区,恢复到独立卷和另一端口,再用原账号登录并通过原连接查询成功。四份 Compose 示例均通过配置校验。导入导出步骤依据官方文档整理,未做生产数据迁移、跨版本升级或 VPS 机房性能测试。
上面的 PostgreSQL 示例用于解释授权范围,具体角色、Schema 和函数权限仍需结合现有数据库检查。本文没有把几条授权语句包装成适合所有生产系统的安全基线。
一个小团队的数据库入口,最终应该能回答三个普通问题:这个人为什么能看到这条连接,他进去后是什么数据库身份,他今天还需要这些权限吗?如果答案明确,新增一位成员就只是一次可控配置;如果答案模糊,管理器越方便,隐患反而越容易被藏起来。