











一个小项目也可能同时用到好几种数据库:PostgreSQL放业务记录,Redis放缓存,脚本导出的SQLite文件留着做离线核对。工具越来越多,真正麻烦的却常常不是查询语法,而是忘记数据在哪台机器、哪个容器和哪个目录。
把DBX放到VPS,可以把这些入口集中起来。不过,统一界面不会统一数据库的工作方式。SQL表、Redis键和MongoDB文档依然各有各的语义,文件型数据库还多了一层路径和锁的问题。这篇围绕“一个浏览器管理多种数据”搭建环境,重点说明哪些地方可以共用,哪些地方必须分开理解。
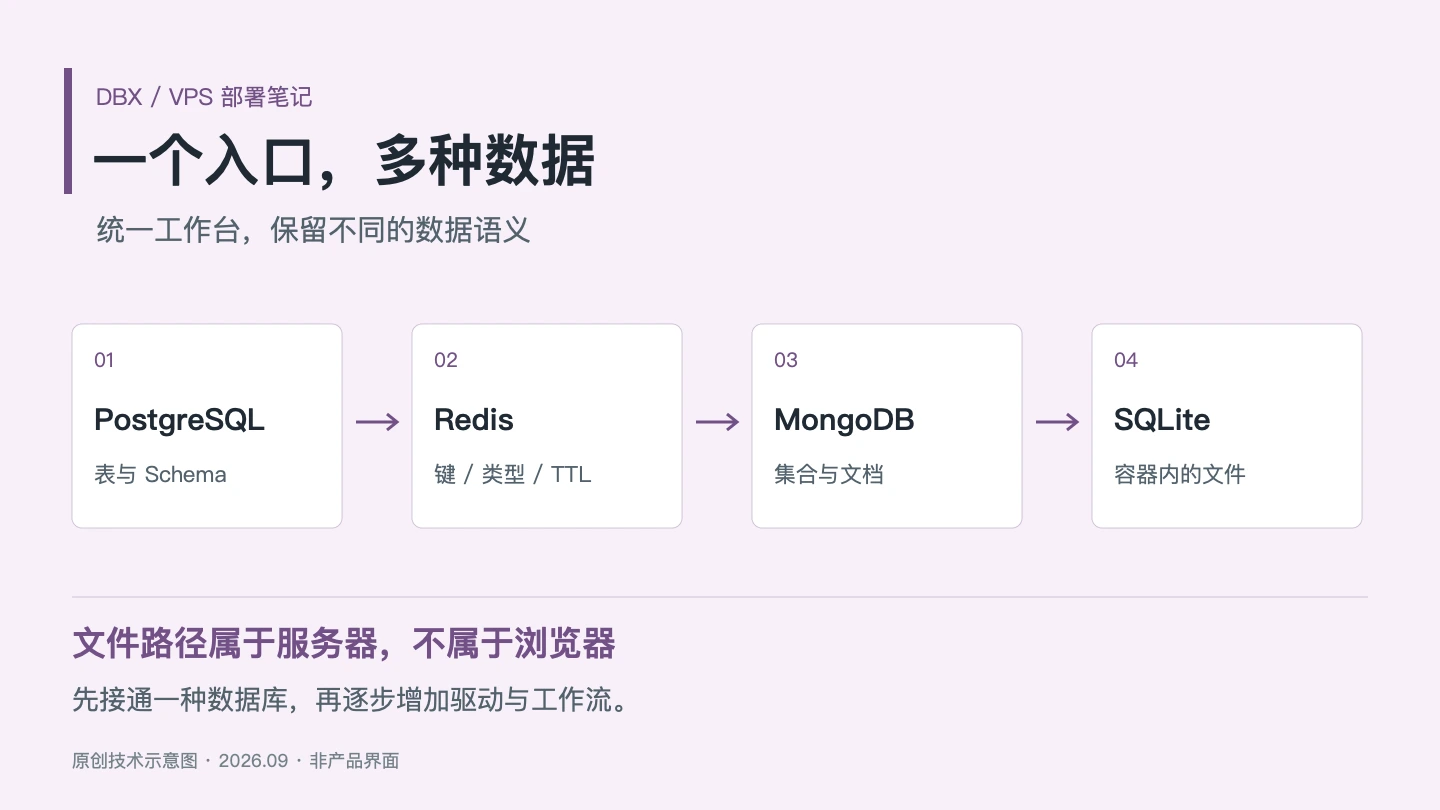
先画出一张自己的数据位置表
部署前,先把准备连接的对象列清楚。下面是一份示例,并不是要求你一次装齐这些数据库。
| 数据来源 | DBX需要访问什么 | 首先确认什么 |
|---|---|---|
| PostgreSQL | 数据库主机与端口 | 数据库、Schema、只读角色 |
| Redis | Redis端点 | ACL账号、逻辑库编号、键前缀 |
| MongoDB | 数据库端点 | 认证库、目标库、文档权限 |
| SQLite | 容器能读到的文件 | 一致性副本、文件权限、写入锁 |
| DuckDB | 文件与相应运行驱动 | Web版驱动、路径、文件格式 |
表里没有“浏览器电脑上的桌面目录”。Web版的后端在VPS,文件路径也从那里计算。你在笔记本浏览器里输入 /Users/me/data.db,容器并不会因此读取到笔记本的文件。
官网目前列出多种SQL、NoSQL和兼容引擎,但不是每种连接都提供完全一样的结构对比、导入或可视化能力。实际工作可以先验证最常用的PostgreSQL和Redis,再逐步增加驱动。DBX项目、数据库支持
VPS部署:状态卷与样例文件目录分开
下面使用Docker Hub镜像0.6.29,只开放本机回环端口。先建立目录与入口密码:
mkdir -p ~/services/dbx-multi/samples
cd ~/services/dbx-multi
umask 077
printf 'DBX_PASSWORD=%s\n' "$(openssl rand -hex 24)" > .env
chmod 600 .env
创建compose.yaml:
name: dbx-multi
services:
  dbx:
    image: t8y2/dbx:0.6.29
    restart: unless-stopped
    ports:
      - "127.0.0.1:4224:4224"
    environment:
      DBX_PASSWORD: ${DBX_PASSWORD:?请先设置入口密码}
    volumes:
      - dbx-data:/app/data
      - ./samples:/samples:ro
    stop_grace_period: 90s
    logging:
      driver: json-file
      options:
        max-size: "10m"
        max-file: "3"
volumes:
  dbx-data:
dbx-data保存工作台状态,samples只放准备给它读取的样例副本。挂载整个个人目录或宿主机根目录没有必要,也很难控制暴露范围。只读挂载能阻止容器写这批文件,但不保证所有驱动都能以只读文件方式打开;某些驱动需要创建锁或辅助文件,失败时要检查驱动方式,而不是立刻把整个目录改成任何人可写。
运行docker compose config --quiet、docker compose pull、docker compose up -d。在本机建立ssh -N -L 14224:127.0.0.1:4224 your-user@your-vps后,打开http://127.0.0.1:14224登录。长期使用可接HTTPS或VPN入口,不必公开数据库端口。
如果缺少练习环境,可以查看雨云当前云服务器。选择时留意DBX到现有数据库的网络;需要分析较大文件时,也要算上文件副本、临时数据和备份的空间。数据库本身已经很忙的VPS,不适合再无计划地塞入大文件分析任务。
PostgreSQL先用作基准连接
为PostgreSQL创建一个独立只读账号,让DBX访问一个演示库。数据库也在Docker时,先让两者加入同一用户自定义网络,再使用数据库服务名和5432。数据库在其他机器时,则用VPS能访问到的受控地址。
保存连接后执行SELECT current_database(), current_user;,接着读几行样例记录。这个动作提供一个基准:网页、入口认证、DBX进程和数据库链路都正常。之后Redis连接出问题,就可以把注意力集中在Redis配置,而不是怀疑整个工作台没有启动。
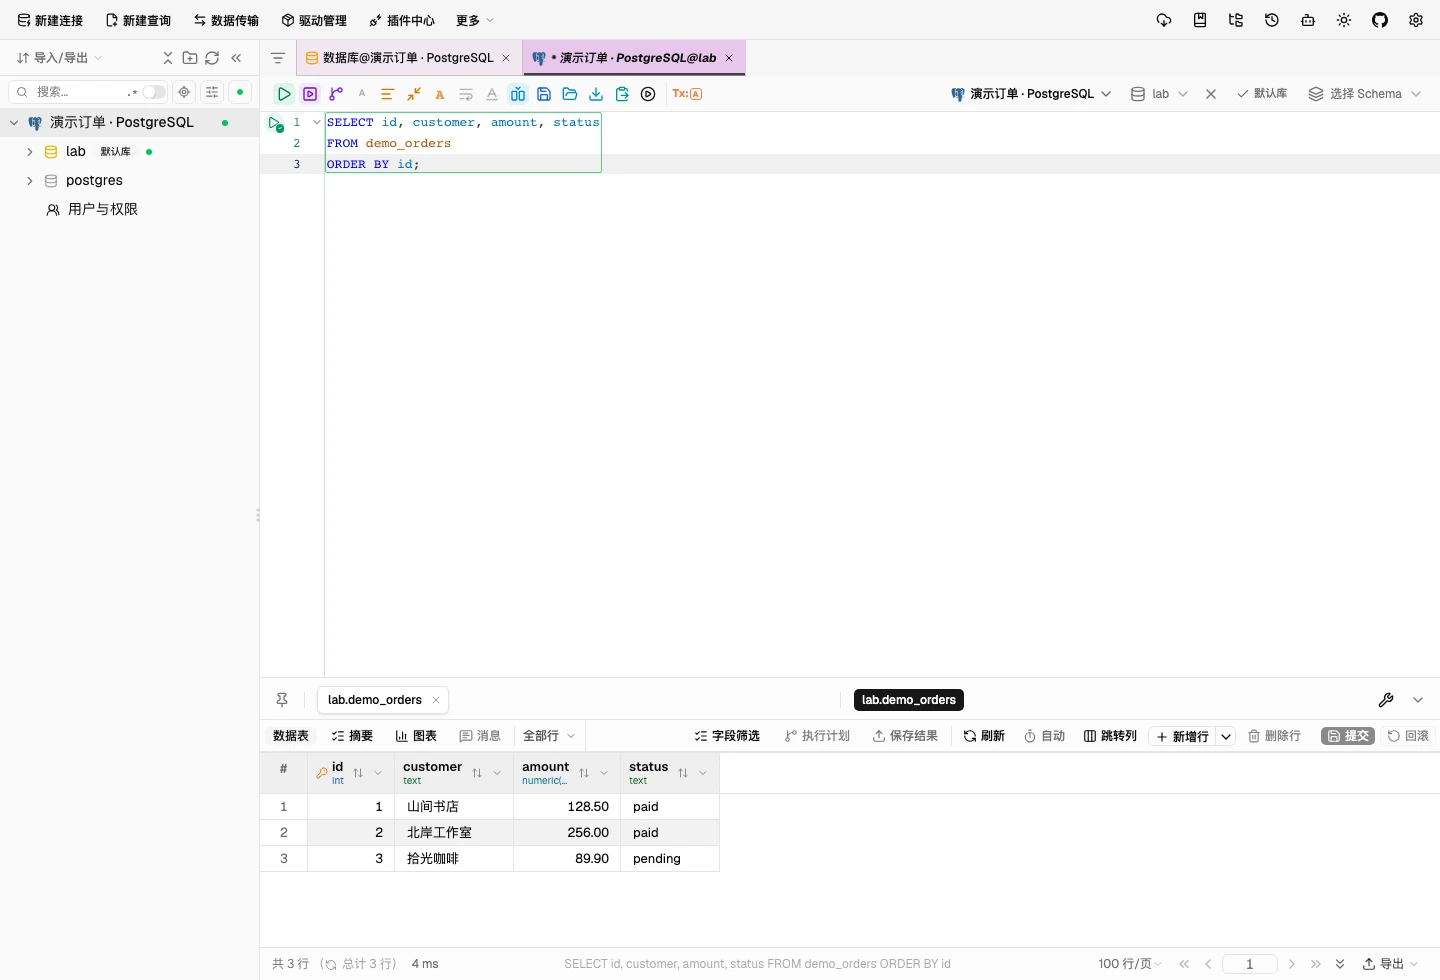
这张图展示PostgreSQL样例;Redis和MongoDB各有专用界面,不会被伪装成同一种SQL表格。
给连接命名时,把环境放在前面、权限放在后面,例如demo-orders-readonly。如果用一个统一入口管理多个站点,名称里再加站点简称。别让十条连接都叫“数据库1”。
Redis先看键的含义,再看值
缓存排查的常见问题是:这个键存在吗、类型是什么、还有多久过期、值是否符合预期。不要一进入工作台就扫描全部键,更不要把清空缓存当成刷新页面的替代动作。
可以在独立演示Redis里准备一个小样例:
SET demo:article:42 "published" EX 3600
HSET demo:profile:7 name "reader" level "basic"
EXPIRE demo:profile:7 3600
上面是Redis命令,只用于演示实例。然后在DBX里按demo:*找键,查看String与Hash的区别,再查看TTL。TTL为-1表示没有过期时间,-2表示键不存在;这两个状态不要混为“缓存已过期”。Redis TTL说明
键名也可能包含用户标识或业务信息,截图前同样需要检查。值很大时先确认查看范围,不要把图形界面的预览理解成无限制、零成本的读取。真正线上使用时,由Redis ACL限制访问前缀和命令,再配合DBX只读连接。DBX Redis工作台
MongoDB别把“有文档”当成“结构相同”
MongoDB同一集合中的文档可能缺字段、类型不同,甚至有旧版本应用留下的结构。查看少量文档时先限定过滤条件和返回数量,再决定是否展开复杂嵌套字段。一个字段在第一条文档中是数字,不代表所有文档都能按数字处理。
连接失败时,除了用户名密码,还要检查认证库。认证用户所在的库与准备浏览的业务库可以不同,这也是SQL数据库使用者刚接触MongoDB时容易忽略的地方。
DBX提供集合与文档操作入口,但本篇不把MongoDB界面当成已实际验证的内容。导入JSON、修改文档、聚合查询之前,先在专用测试集合里确认当前版本行为。删除字段与把字段值写成null并不等价,批量修改尤其需要事先记录影响范围。MongoDB工作台文档
SQLite:先做一致性副本,再挂进容器
正在被应用使用的SQLite数据库,不宜随手只复制主文件。启用WAL时,部分已提交内容可能还在WAL文件里。可以在拥有合适权限的环境使用SQLite备份命令生成副本:
sqlite3 /path/to/source.db ".backup '/path/to/export/sample.db'"
确认命令成功后,把副本放进前面的samples目录,DBX看到的路径就是/samples/sample.db。本文没有要求你把源业务文件直接挂进容器,更没有要求DBX与业务应用争用同一个可写文件。SQLite在线备份说明
只读查看失败时,先检查容器能否读取文件、父目录能否遍历、文件是否为完整副本,以及驱动是否需要写入辅助文件。如果确实需要可写练习副本,另建专用目录,只复制测试数据,不要解除生产目录的保护。
DuckDB也要按文件位置和驱动能力来判断。需要额外驱动时,在DBX驱动管理中查看当前状态,不要把桌面安装包里能用的能力直接套到Web镜像。Parquet相关导入也有目标引擎限制,并非所有数据库连接都能接收同样格式。驱动管理、表数据导入
ER图和结构对比,用来发现问题,不替你决定变更
对关系型数据库,ER图能帮助理解表之间的关系;但如果库里没有声明外键,图也不可能准确推断所有业务关联。字段血缘同样依赖可见元数据和解析范围,不能当成业务影响的完整清单。
比较测试与正式Schema时,先明确源和目标,再检查生成SQL。新增字段与删除字段的风险不一样,类型变化还可能触发重写、锁和数据转换。DBX给出的差异适合审查,执行变更仍应走你自己的备份和发布流程。Schema与数据对比
把多库工具用顺手的诀窍,是统一入口、分别验证。连接清单可以集中,账号权限和操作习惯不能偷懒合并。PostgreSQL的只读角色不会替Redis限制命令;只读挂载也不会替MongoDB限制文档更新。
**本文验证范围:**2026 年 9 月 30 日,在本地隔离 Docker 环境运行 DBX 0.6.29(ARM64)与 PostgreSQL 18.6,完成网页密码登录、保存连接、三行样例查询,以及数据库只读角色拒绝 UPDATE 的检查;停止 DBX 后备份完整卷,恢复到独立卷与端口,再次登录并使用保存的连接查询成功。本文没有在生产 VPS 安装 DBX;1Panel 点击安装、公网证书签发、MongoDB、文件数据库、批量导入导出和跨版本升级未作实测,相关步骤依据官方资料与部署原理说明。
等这几个连接稳定以后,再考虑添加AI接口、更多驱动或其他数据库。先让最常用的任务少走几步,比一次点亮所有功能更容易长期维护。