











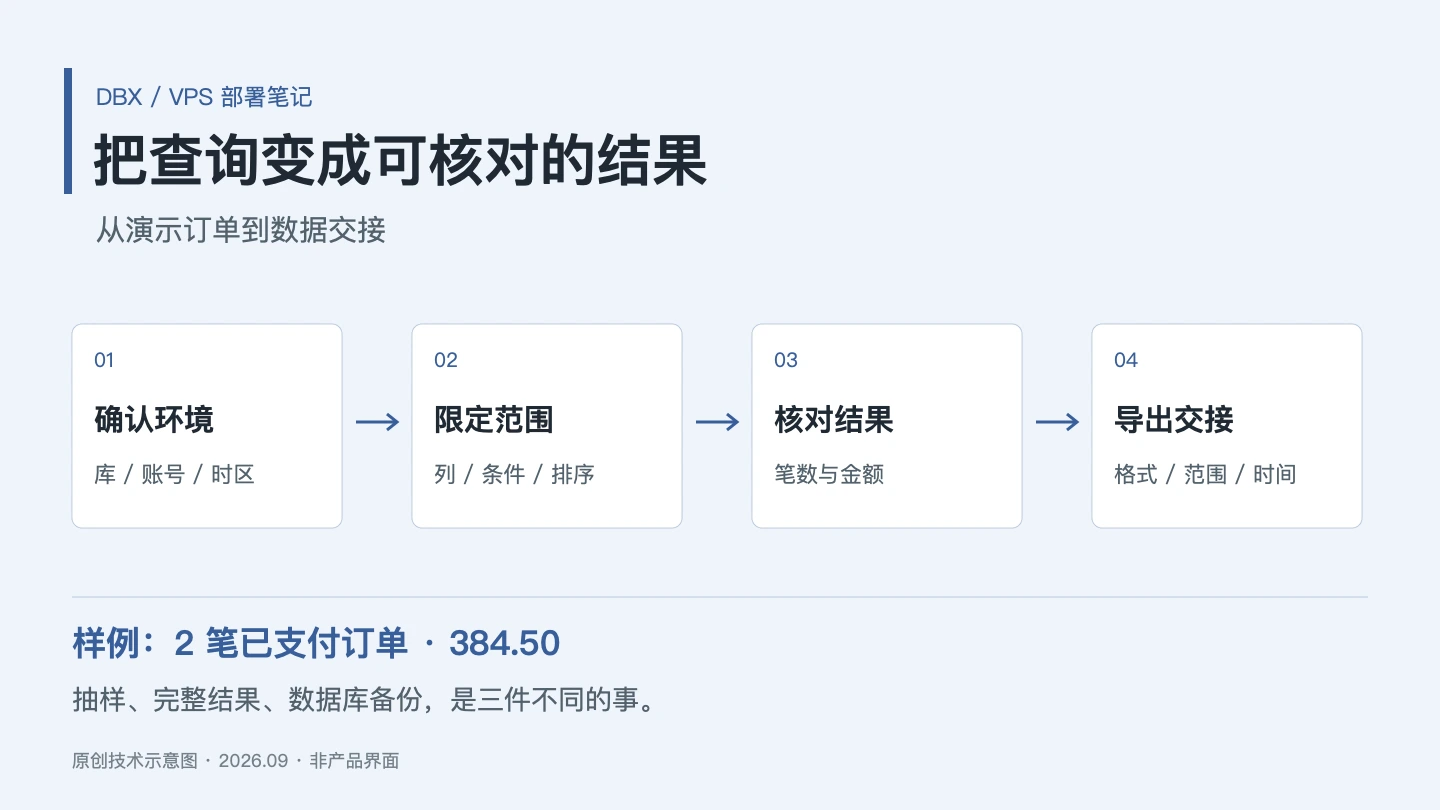
“导一份订单给我”听起来像一个按钮能解决的事,真正容易出问题的地方却都在按钮之外:查的是哪个库,时间按哪个时区算,金额有没有被表格软件改成浮点数,导出的到底是整表还是当前结果。
DBX 可以把查询和数据浏览放到浏览器里。部署在 VPS 后,换电脑时不用重新安装数据库客户端,但对结果负责的仍然是使用者。这篇从 Docker 部署开始,用一个 PostgreSQL 演示库走完查询、核对、导出的工作流,再说为什么导入应该先经过暂存表。
先搭一个只对自己开放的 Web 工作台
以下示例使用 t8y2/dbx:0.6.29,要求 VPS 已安装 Docker Engine 和 Compose 插件。把文件放在独立目录,不要混进已有业务应用的 Compose 项目。
mkdir -p ~/services/dbx-query
cd ~/services/dbx-query
umask 077
printf 'DBX_PASSWORD=%s\n' "$(openssl rand -hex 24)" > .env
chmod 600 .env
compose.yaml:
name: dbx-query
services:
  dbx:
    image: t8y2/dbx:0.6.29
    ports:
      - "127.0.0.1:4224:4224"
    environment:
      DBX_PASSWORD: ${DBX_PASSWORD:?请设置入口密码}
    volumes:
      - dbx-data:/app/data
    restart: unless-stopped
    stop_grace_period: 90s
    logging:
      driver: json-file
      options:
        max-size: "10m"
        max-file: "3"
volumes:
  dbx-data:
运行 docker compose config --quiet,检查通过后执行 docker compose pull 和 docker compose up -d。在个人电脑建立 ssh -N -L 14224:127.0.0.1:4224 your-user@your-vps,浏览器访问 http://127.0.0.1:14224,使用刚生成的入口密码登录。
该入口不需要给公网开放4224。需要正式域名时,可以由宿主机 Caddy 代理到回环4224,并保留密码保护。数据库地址则从 DBX 容器的网络位置计算;同网络的 PostgreSQL 使用服务名和5432,远程数据库使用受控内网地址。浏览器电脑的 localhost 与这里无关。DBX 快速开始
准备一份不会误伤业务的练习数据
下面的表只在独立演示库创建,不要放进生产库照着练。由演示库的建表账号执行:
CREATE TABLE demo_orders (
  id integer PRIMARY KEY,
  customer text NOT NULL,
  amount numeric(10,2) NOT NULL,
  status text NOT NULL,
  created_at timestamptz NOT NULL
);
INSERT INTO demo_orders VALUES
  (1, '山间书店', 128.50, 'paid', '2026-09-20 10:00:00+08'),
  (2, '北岸工作室', 256.00, 'paid', '2026-09-21 11:00:00+08'),
  (3, '拾光咖啡', 89.90, 'pending', '2026-09-22 12:00:00+08');
随后给 DBX 单独配置一个只读数据库角色,只授予连接、Schema使用和这张表的SELECT权限。建表账号与日常查询账号分开,练习时就能看见权限边界,而不是等到线上误操作后才补。
如果你还没有适合练习的服务器,可以查看雨云的云服务器方案。这个场景先考虑数据库和管理器之间的网络、备份空间,再看核数。把演示环境与正式站点分开,通常比在正式机器上临时加一堆高权限账号更省心。
第一条 SQL,先确认自己站在哪里
打开查询标签后,不急着写业务条件。先执行:
SELECT current_database() AS db,
       current_user AS role,
       current_setting('TimeZone') AS timezone;
核对库、账号和时区,再看编辑器当前选中的连接。尤其当多个标签页同时存在时,标签标题中的环境信息值得多看一眼。相同表名可能存在于测试、正式和历史归档库,查询成功并不证明查对了地方。
DBX 编辑器有补全、格式化和执行范围选择。草稿里有多段SQL时,明确选中要执行的部分;不要默认快捷键永远只执行光标所在一行。自动补全能减少拼写错误,却不能替你判断业务口径。查询编辑器说明
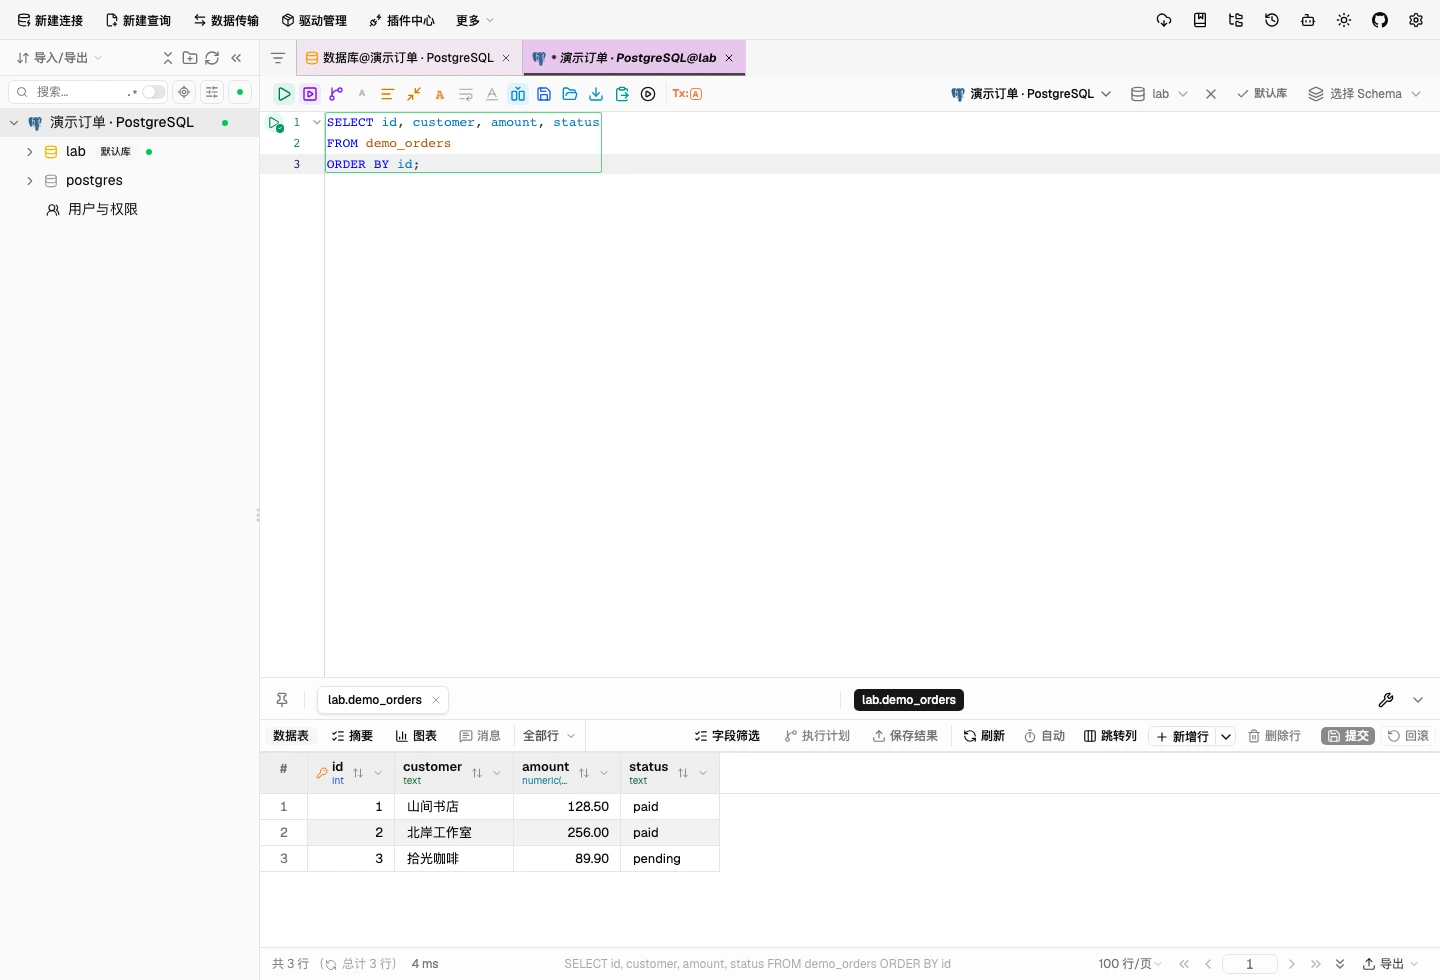
截图使用虚构订单,展示的是实际运行界面。金额字段采用 numeric,而不是为了截图临时拼出的表格。
把查询范围写到别人也能复核
查询已支付订单,可以从很小的结果开始:
SELECT id, customer, amount, created_at
FROM demo_orders
WHERE status = 'paid'
  AND created_at >= TIMESTAMPTZ '2026-09-01 00:00:00+08'
  AND created_at <  TIMESTAMPTZ '2026-10-01 00:00:00+08'
ORDER BY created_at, id
LIMIT 100;
这里显式写列名,不把未来新增的敏感字段顺带导出;时间区间使用左闭右开,避免在“月底23点59分59秒”之后漏掉更高精度时间;排序加入id,让同一时间的记录也有稳定次序。LIMIT 100用于抽样检查,不应被误称为当月全部订单。
确认条件后,再单独算笔数和金额:
SELECT count(*) AS order_count, sum(amount) AS total_amount
FROM demo_orders
WHERE status = 'paid'
  AND created_at >= TIMESTAMPTZ '2026-09-01 00:00:00+08'
  AND created_at <  TIMESTAMPTZ '2026-10-01 00:00:00+08';
本文样例应得到2笔、384.50。把这个核对值与导出文件一起记录,别人拿到文件时就有一个能检查的基准。正式数据不停变化时,两次查询可能处于不同快照;需要严格一致的报表,应由数据库侧一致性事务或专门报表流程保障,而不是靠两次点击之间足够快。
LIMIT也不等于查询成本很低。前面有复杂连接、排序和聚合时,数据库可能先处理大量数据才返回少量行。需要分析计划时,先弄清所用入口是普通EXPLAIN还是会实际执行查询的EXPLAIN ANALYZE,不要在高峰期拿重查询试手。
导出之前,先确认“导出的范围”
DBX 的数据表格提供复制和导出入口,结果集、表数据及不同格式的具体能力应以当前界面为准。不要把滚动条能继续往下拉,理解为浏览器已经拿到了完整表;虚拟滚动、分页和导出任务是不同机制。数据表格文档
小份交接文件至少核对五件事:字段顺序、数据行数、中文编码、时间时区、NULL与空字符串的区别。订单号、手机号、带前导零的编号应按文本处理,避免电子表格自动改成数字或科学计数法。
文件命名可以包含日期和范围,例如 paid-orders-2026-09-sample.csv。抽样文件明确写sample;完整报表则保存最终SQL和生成时间。不要把服务器密码、连接字符串或访问令牌顺手写进说明文件。
CSV很通用,但它没有数据库的类型约束,也不包含索引、权限、外键和完整事务状态。它适合交接结果,不适合承担灾难恢复。需要恢复库时,另用数据库备份工具。
导入先落暂存表,不直接碰正式订单
假设有人回传了需要核对的编号和金额,先在演示库建立一张文本暂存表:
CREATE TABLE import_orders_stage (
  source_id text,
  amount_text text,
  note text
);
导入账号需要这张暂存表的写入权限,但不必拥有正式订单表的修改权限。在DBX导入向导中检查表头、编码、字段映射和目标表,选择追加模式。预览中的十行没有问题,不代表文件后面的十万行都没有问题。表数据导入说明
先用文本接住外部数据,可以保留错误原貌。检查重复编号:
SELECT source_id, count(*)
FROM import_orders_stage
GROUP BY source_id
HAVING count(*) > 1;
再检查缺值和金额格式:
SELECT * FROM import_orders_stage
WHERE source_id IS NULL OR btrim(source_id) = ''
   OR amount_text IS NULL
   OR btrim(amount_text) !~ '^[0-9]+([.][0-9]{1,2})?$';
这个格式规则只是本例的非负两位小数规则,不适合直接套到允许退款负数、千位分隔或其他币种精度的数据。数据清洗的规则来自业务,不来自导入工具。检查通过后再设计正式合并SQL,并在独立事务和备份条件下执行。
对于“清空后导入”,不要默认失败一定全部回滚。不同数据库、批次和清空方式的事务行为不同。半途失败时先核对已经写入多少行,再决定重试方式,否则重复导入可能把一次问题变成两次。
AI 助手可以帮忙写,但口径要自己给
比较合适的请求是给出脱敏表结构、限定字段和输出要求,让助手起草查询,再回到编辑器逐项审查。比如“按北京时间统计九月paid订单,不返回客户名称”,就比“分析一下所有订单”清楚得多。
配置外部模型接口意味着相关上下文可能发送给该服务。不要为了补全一条SQL,把真实客户记录、数据库密码和整份业务字典一并上传。本文不配置付费AI接口,也不把生成结果当成已验证SQL。DBX AI 助手
**本文验证范围:**2026 年 9 月 30 日,在本地隔离 Docker 环境运行 DBX 0.6.29(ARM64)与 PostgreSQL 18.6,完成网页密码登录、保存连接、三行样例查询,以及数据库只读角色拒绝 UPDATE 的检查;停止 DBX 后备份完整卷,恢复到独立卷与端口,再次登录并使用保存的连接查询成功。本文没有在生产 VPS 安装 DBX;1Panel 点击安装、公网证书签发、MongoDB、文件数据库、批量导入导出和跨版本升级未作实测,相关步骤依据官方资料与部署原理说明。
日常工作里,数据库工具最有用的地方不是按钮多,而是减少重复劳动,又能留下可复核的结果。先确认连接,再写清范围,最后核对文件,这个顺序用熟了,换成别的客户端也一样受用。