











收藏一份 Jev 项目清单很容易。真准备接入时,问题会变得具体:我需要一个命令行过滤器,还是一个 MCP 服务?工具输出太长,应该在进入上下文前筛选,还是在会话压缩时处理?给代码审查加一个评分,能省下哪一部分工作?
这次沿着一份“20 个 Jev 项目”清单,逐个核对了仓库、README 和关键文档。更适合工程师的阅读顺序,是先选一个现有流程里的小问题,再找接口形态相符的项目。把二十个工具一起装上,很难分清收益来自哪里。
以下是截至 2026 年 9 月 23 日的资料核对与接入建议,不是二十个项目的安装实测。下文的试验方案由本文设计,仓库演示数据会注明出处。
先决定你要改哪一段流程
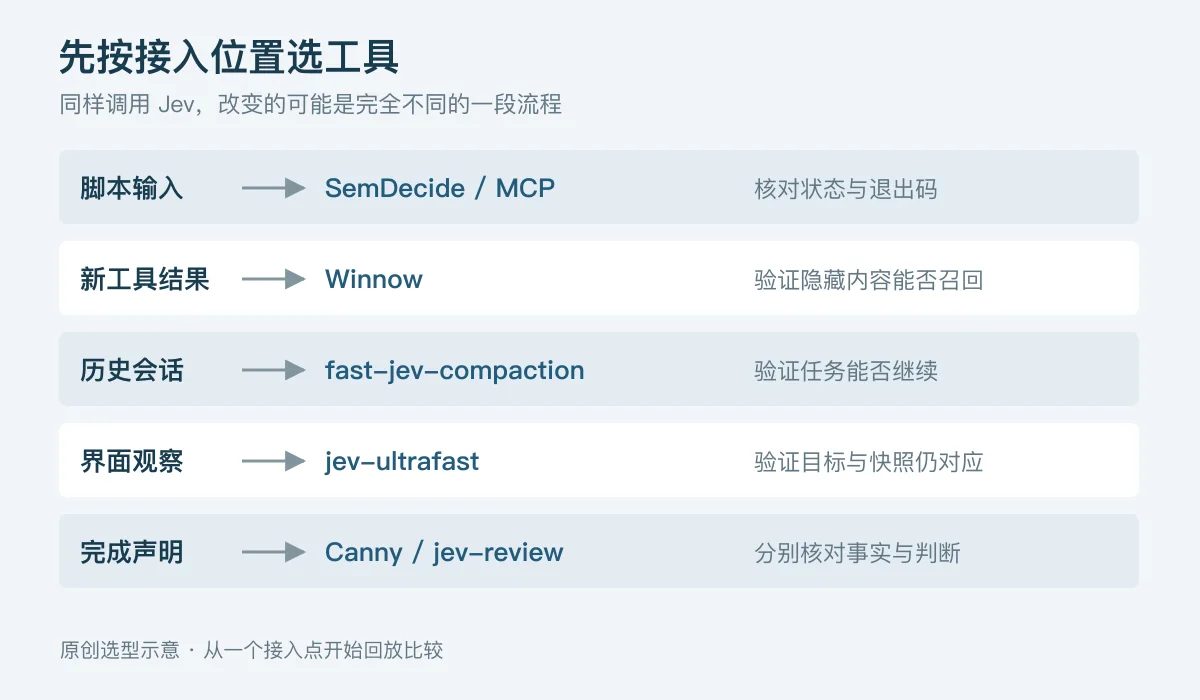
图为原创选型示意。按工作发生的位置选工具,可以减少功能重叠。
| 当前遇到的问题 | 先读哪个项目 | 第一轮只验证什么 |
|---|---|---|
| 脚本缺少语义分类能力 | SemDecide | 输入、输出、不确定结果和退出码 |
| Agent 需要调用一个判断工具 | typesafe-mcp 或 jev-mcp | 调用是否必要,证据是否充分 |
| 新产生的工具输出太长 | Winnow | 被隐藏的关键证据能否找回 |
| 已有会话历史太长 | fast-jev-compaction | 裁剪后能否继续完成同一任务 |
| 页面操作每一步都很慢 | jev-ultrafast | 候选元素是否完整、动作是否过期 |
| Agent 宣称完成却没有验证 | Canny | 代码版本与验证记录是否对应 |
这里没有统一的“最佳项目”。例如,一个定时处理 JSONL 的脚本,通常不需要再引入 Agent 和 MCP。反过来,已经在 Agent 中完成的工作,也不必为了一个判断额外维护一套命令行协议。
用 SemDecide 做第一轮可回放试验
SemDecide 提供语义谓词、选项路由、评分和流式过滤。它有价值的部分包括退出码:当前文档将普通命令的确定匹配、确定不匹配、本地输入错误、不确定结果、服务失败分别编码。
假设要筛选发布说明里可能改变接口行为的条目,可以先拿一份历史材料试跑。下面的脚本展示如何保留不同状态;需先按项目说明安装并配置凭证,本文没有调用付费 API 执行它。
# changelog.txt 应为允许发送给模型服务的试验材料。
# 在 if 中调用,避免 set -e 将预期的非零判断结果直接终止。
if semdecide is 'This change alters externally observable API behavior' \
    --json < changelog.txt > verdict.json; then
  result_code=0
else
  result_code=$?
fi

case "$result_code" in
  0) echo '进入接口变更复核队列' ;;
  1) echo '未匹配该条件;保留原始记录' ;;
  3) echo '模型不确定,进入人工复核' ;;
  2) echo '检查本地输入与命令参数' >&2 ;;
  4) echo '服务失败,等待重试或人工处理' >&2 ;;
  *) echo '未识别状态,停止消费结果' >&2 ;;
esac
这段示例针对 is 命令。仓库的 guard 配方有另一套退出码约定,不能直接套用。
第一轮不删除记录,也不改变发布结果。把输入、原始响应、退出码和人工标签放在一起,重点找“模型说不匹配,但实际存在接口变化”的漏判。如果最简单的关键词规则已经能够完成大部分工作,保留规则,只让模型处理剩余的语义歧义。
同时记录超时和限流。将服务失败统计成“不相关”,会让过滤器看起来既快又果断,却把未处理的数据悄悄排除掉。
MCP 选薄接口,还是选任务工具箱
itsmostafa/typesafe-mcp 暴露通用的 evaluate 工具,调用者提供状态和问题。它适合已经知道要问什么、希望自己控制标签与量表的团队。
jkudish/jev-mcp 则把主张核验、重排、分类、diff 审阅等任务封装成多个工具。它适合先借用现成任务边界,再观察 Agent 如何调用。
可以拿同一批文档做比较:通用接口由你写好“主张与证据”的问题,工具箱调用现成的核验工具。检查二者是否都保留“证据没有提及”的结果。检索不到证据时,别把模型返回的支持或反对当作额外信息。
工具数量也不是收益指标。一次普通文件读取之后,Agent 若又调用三轮判断,只为了确认“下一步继续读取”,可能增加总延迟。日志里至少要能回答:哪个判断改变了后续步骤?没有改变步骤的判断,是否还值得保留?
Winnow 和会话压缩,改的是两个时刻
Winnow 在工具结果进入上下文时筛选内容块,保留不确定的内容,并为隐藏内容提供本地召回入口。fast-jev-compaction 面向已有会话,决定哪些工具调用和结果需要保留,保留的原文不做改写。
“输出保留原文”和“判断时看到全部原文”要分开理解。fast-jev-compaction 的当前 README 说明,发送给 Jev 的判断状态会用简短标记替代工具结果,并在预算不足时进一步缩减状态。不能把它描述成逐字读完全部历史输出后再做选择。
给这两种工具准备的回放任务,也应有所区别:
- 测 Winnow 时,把关键报错放在长输出中间,随后提出只有读到它才能回答的问题,再检查召回是否成功。
- 测会话压缩时,先执行一段较长任务,压缩后继续原任务,检查路径、用户约束和未解决错误是否仍可追溯。
还要准备一种很常见的情况:压缩时某段内容看起来无关,下一轮用户却要求追查它。保留了本地原文,不等于 Agent 一定知道应该召回;召回键是否可见、缓存是否仍在、路径是否仍对应原版本,都值得验证。
不要只比较节省了多少 tokens。把“省下的读取成本”和“重新寻找遗漏证据花掉的成本”一起记录,才能判断压缩是否改善了整个任务。
浏览器项目先检查目标绑定,再看速度
jev-ultrafast 将当前页面上的控件编成候选表,让 Jev 选择操作与目标。需要输入文本时,再交给生成模型。README 展示了约 7.1 秒完成特定航班搜索的演示,这不是对任意网站的速度承诺。
对准备做网页自动化的团队,仓库中关于目标验证的实现更值得读:选择的是已经观察到的节点,执行前再次检查页面状态、元素与遮挡。代码没有直接把模型输出当成任意选择器或 JavaScript 执行。
在自己的测试页上,可以安排三个扰动:模型返回前插入一条新列表项;让一个浮层盖住目标按钮;在点击成功但回执延迟时触发重试。分别检查系统会不会点错行、穿透遮挡,或重复提交。
这些测试通过后,再比较端到端延迟。只计模型返回的时间,会漏掉页面加载、文本生成、等待控件出现与重试的成本。
桌面方向可以读 agent-desktop。它采用操作系统无障碍树组织 UI。应先确认你的目标软件能暴露足够完整的控件,再考虑决策模型:没有进入候选表的按钮,模型无法凭概率把它选出来。
审查建议和完成证据分别验收
devagrawal09/jev-review 把审查拆成风险判断、文件画像、证据选择和严重度评估,并提供本地看板。试用时可以放入一组已有审查结论的历史改动,检查它能否把审阅人带到正确位置。
Canny 处理另一件事:记录修改与命令执行等事件,用确定性规则约束完成声明,Jev 提供辅助判断。它适合用来讨论“完成证据”的存储形式。
例如,Agent 在版本 A 上运行测试后,又改出版本 B。账本里虽然存在一次成功测试,这次测试未必覆盖 B。接入监督工具时,应检查记录是否绑定到对应修改,而不只搜索历史里有没有一个退出码为零的命令。
两种工具可以分别试验。先测审查有没有减少漏看,再测完成检查能否识别过期或缺失的验证记录。若同时接入,很容易把“审查分数很高”误读成“测试证据充分”。
二十个项目按用途重新索引
下面保留原清单涉及的二十个项目,便于继续查阅。用途依据当前仓库资料;“第一处要查”是本文建议的阅读入口,不是作者给出的性能结论。
| 项目 | 可以借鉴的用途 | 第一处要查 |
|---|---|---|
| jev-ultrafast | 网页操作与候选目标选择 | 快照与执行前验证 |
| agent-desktop | 桌面控件观察与操作 | 目标应用的无障碍树覆盖 |
| typesafe-mcp | 通用判断入口 | 问题与标签定义 |
| jev-mcp | 核验、分类、重排工具箱 | 每个工具需要的证据 |
| SemDecide | Shell 与数据流判断 | 退出码与失败分支 |
| fast-jev-compaction | 历史会话裁剪 | 判断状态与实际保留内容的区别 |
| Winnow | 工具结果入上下文前筛选 | 隐藏内容的召回路径 |
| jev-codex-router | 按调用选择模型与推理档位 | 路由失败后的回退策略 |
| jev-review | 分阶段审查与本地报告 | 证据选择是否漏掉关键改动 |
| Canny | 完成声明与事件记录核对 | 最近修改之后的检查证据 |
| Blink | 按路径名称探索代码位置 | 无明显语义的文件名会不会漏检 |
| json-render | 在给定组件候选中组合 UI | Jev 实验功能的实际发布状态 |
| neo4jev | 在图关系候选中逐步导航 | 错过分支后是否还有探索预算 |
| jev-curate | 数据流筛选与量表评估 | 模拟测试与真实服务吞吐的区别 |
| typesafe-mario | 从游戏状态选择控制动作 | 状态解析与决策延迟 |
| jev-drone | 仿真中的低频战术判断 | 高频控制与模型建议的分工 |
| OneVOneJev | 游戏内的结构化动作选择 | 服务不可用时的启发式回退 |
| jev-trader | 观察订单簿决策循环 | mock、模拟成交与真实调用标记 |
| Prism | 旁路记录市场状态判断 | Jev 建议与确定性执行的边界 |
| killmyidea | 多维评分转成有限结论 | 权重与阈值如何影响结果 |
列表称为“公开项目”,没有把仓库可见性直接等同于已完成开源许可核验。核对时,Blink、typesafe-mario、OneVOneJev 和 killmyidea 的 GitHub 仓库元数据未识别出许可证;复用前还需要查看具体文件与当前授权说明。
三条容易被清单省略的信息
第一,json-render 的 Jev 官方指南 当前将相关 API 标为实验性、尚未发布,给出的是源码构建路径。不能仅凭“支持 Jev”就认定安装某个 npm 稳定版本后一定能使用。
第二,jev-curate 当前 README 将 24.0 行/秒标为本地 mock 基准,把 1500+ 行/秒列为集群目标。这两者都不是已经验证的真实 Jev 服务吞吐。并发数、限额、输入长度和重试会影响实际处理量。
第三,Prism 的范围需要说清楚:它的 Jev 判断服务声明用于旁路观察与建议,不直接驱动进入或退出;Prism 整个应用仍包含交易执行流程。把“Jev 不下单”缩写成“这个项目不会下单”,会漏掉重要区别。
带着一张回放表开始
第一轮只选择一个项目,用固定的历史输入记录:预期结果、原始模型结果、最终采取的分支、失败类型、端到端耗时和人工修正。再加上仓库提交版本与实际模型标识,之后才能比较升级前后发生了什么。
如果结果显示工具只是多加了一次判断,却没省下后续工作,就先移除它。如果它在某一类窄任务里稳定减少重复劳动,再逐步扩大输入范围。公开仓库最有用的价值,是提供可以阅读和拆解的实现;把其中一段接进自己的流程,收益通常比收藏整份清单更容易验证。
延伸阅读:Jev 与 Laya 的测试接入实践,讨论失败日志分诊、中文输入与动作阈值。