Search
三百万条规则的反向匹配设计
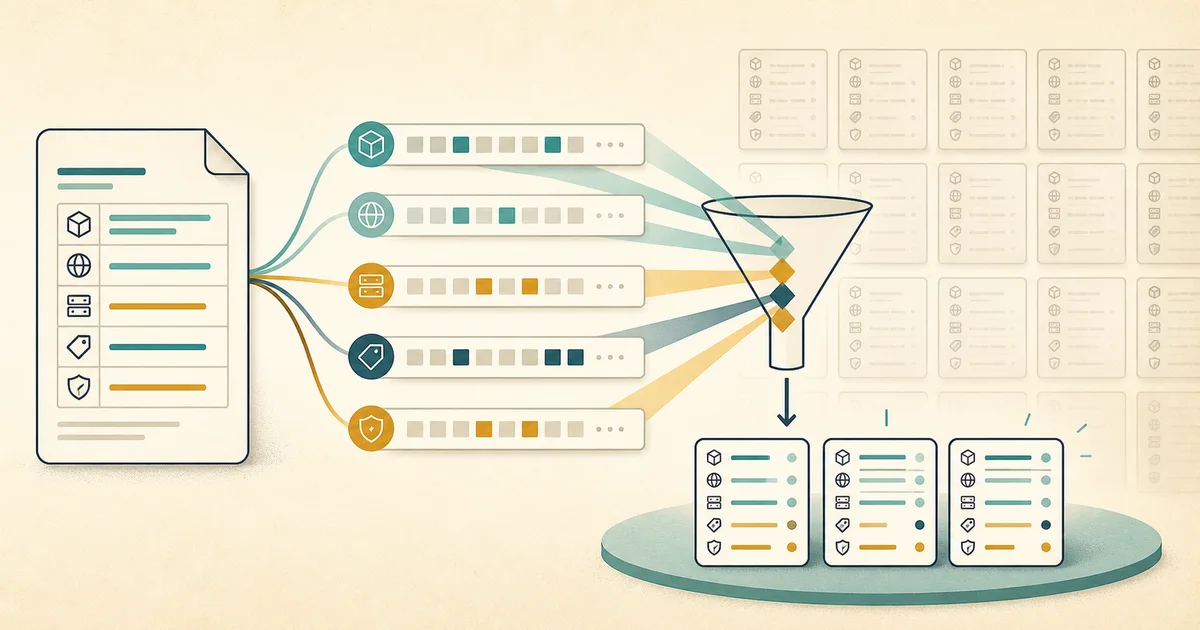
用参考解释器与倒排编译器重现漏召回,跑通缺失、多值、区间端点与兜底测试,再推导三百万规则的内存、更新和撤销边界。
用 Elasticsearch 做商品圈选
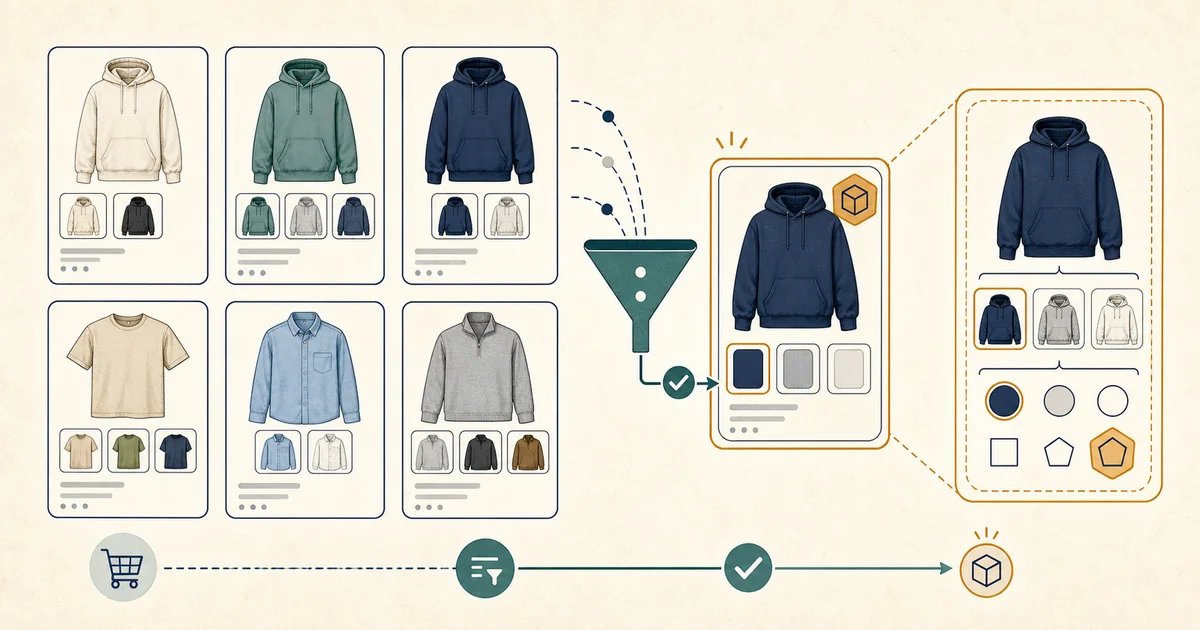
从红色高价与蓝色低价的跨 SKU 误匹配开始,建立可运行的字段模型与查询,处理缺货否定、商品级结果,以及 PIT 配合 search_after 的固定视图导出。
PostgreSQL 站内搜索实践
用 PostgreSQL 18 的独立小语料和三万条合成标题,实测中文切词、字面包含、英文纠错与查询计划,完成一套能解释结果、能控制成本的站内搜索方案。
PostgreSQL 站内搜索实践
用 PostgreSQL 18 的独立小语料和三万条合成标题,实测中文切词、字面包含、英文纠错与查询计划,完成一套能解释结果、能控制成本的站内搜索方案。
Google 的 Coding 差距,不只是模型排名问题
围绕 Pichai 在 Hard Fork 访谈中的 AI 讨论,把 Google Coding 差距放回反馈循环、开发者工作流、Search AI Mode 和 AGI 治理的同一张图里看。
Google AI 编程差距怎么审:别只看榜单,要看工作流信号
把 Google 的 AI 编程差距放回可审计的证据链里:榜单只能看结果,真正重要的是开发者工作流、产品反馈、Antigravity 增长口径和 Search AI Mode 的治理边界。
SAG 不是又一个 RAG 变体:它在重建知识库的证据链
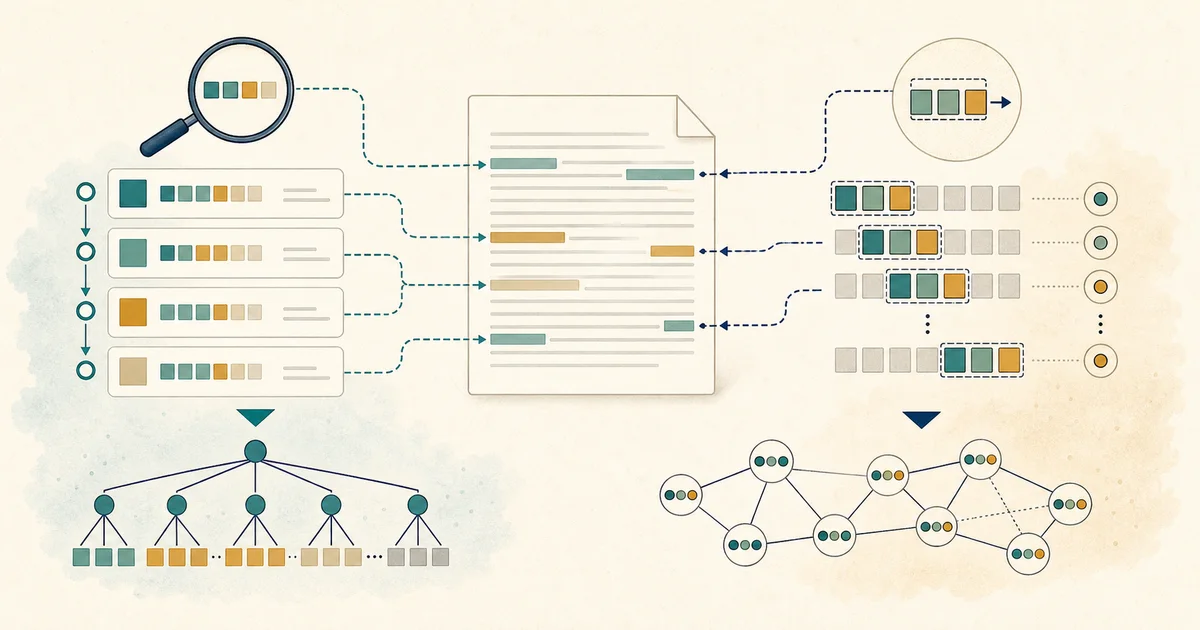
把文档切片、事件、实体和查询时动态超边结合起来,解决多跳检索里最容易断掉的证据链。
SAG 不是另一个向量库:它在重建知识库的证据链
SAG 的重点是把 Chunk、Entity、Event 和动态关系链结合起来,解决普通 RAG 多跳证据容易断的问题。