RAG
Jev 应用场景图谱:从客服分流到 RAG、Agent 闸门与实时决策
面向工程团队的 Jev 实用场景图谱:按客服 intake、模型路由、agent 工具闸门、RAG 过滤、评测 guardrails、候选集抽取、审核风控、批量标注和实时控制拆解 Choice、Score、Noul 决策契约。
语义理解与向量相似度
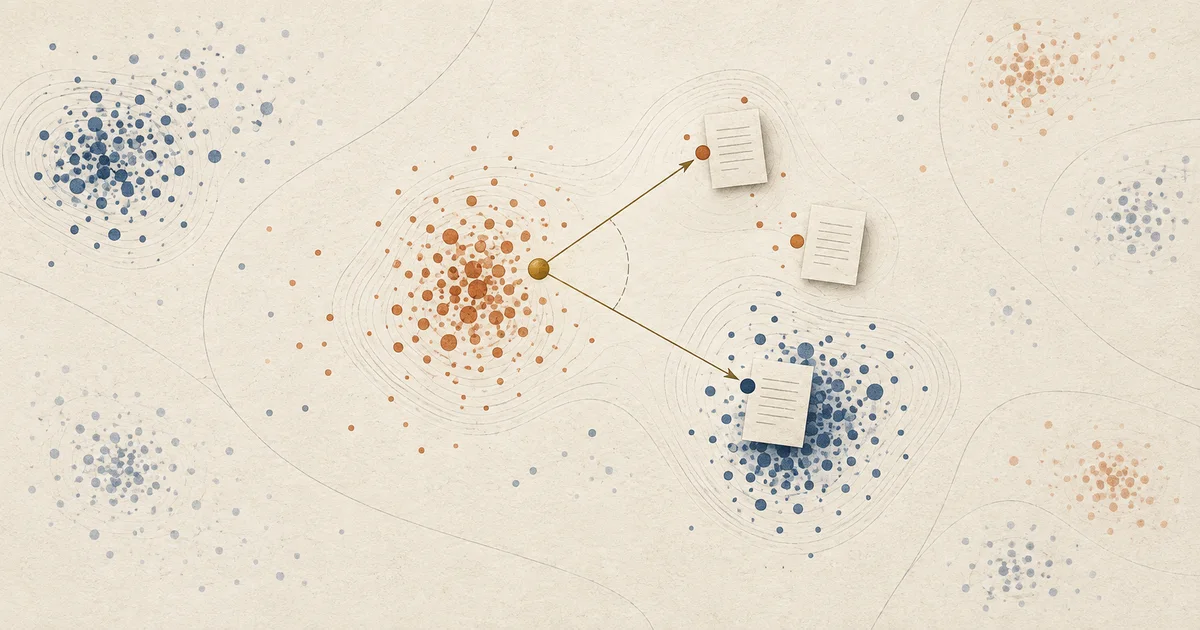
向量相似度高,为什么检索结果仍然答非所问?从 Embedding 的训练目标讲起,分析余弦相似度、点积与欧氏距离,说明 BM25、混合检索、Rerank 和评估指标各自解决的问题。
PixelRAG 值得接入吗:用表格问题检查检索时丢了什么
从产品规格表的行列关系出发,解释 PixelRAG 的截图检索流程,设计可复查的小规模比较,并核算更新、权限、存储和阅读成本。
PixelRAG:把表格和版式重新放回 RAG 的证据链
PixelRAG 通过截图瓦片和视觉嵌入保留网页表格、图表与布局,本文从工程成本与混合检索角度判断它的适用边界。
PixelRAG 不替代文本 RAG:它补上视觉证据这一层
从表格、图表和页面布局出发,分析 PixelRAG 如何与文本检索协作,以及如何用可量化的试点判断是否值得引入。
企业知识库的检索与权限控制
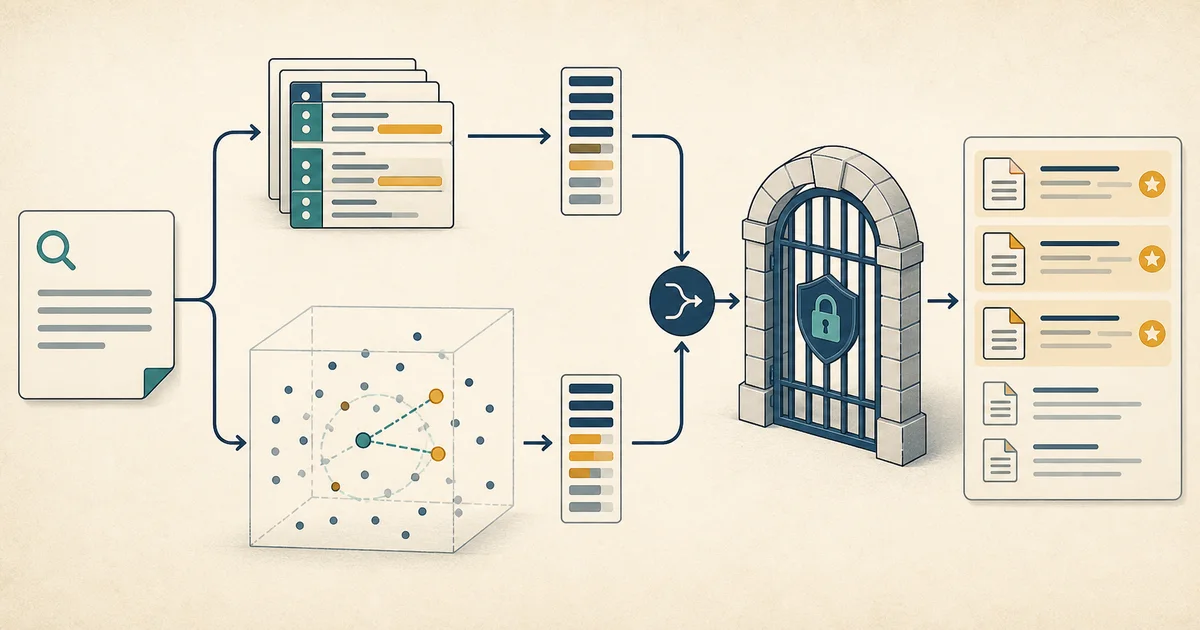
从五份制度和故障文档出发,手算并运行 RRF 融合,复现重复切片、后过滤漏检和召回后撤权,区分业务评测与模型效果。
本地 PDF 解析不只是省一次 OCR:pdf-inspector 正在变成文档流水线的前置基础设施
pdf-inspector 用 Rust 核心把 PDF 分类、阅读顺序、表格抽取和 Markdown 生成放到本地完成,适合作为文档流水线与 RAG 的第一层路由,而不是把所有文档都先扔给 OCR。
MinerU 接入 RAG:从一张错位表格检查解析、引用和入库版本
以参数表格问答为例设计 MinerU 文档入库验收,更新 4.0 的入口、页范围和输出协议,并说明表格、公式、引用、版本回退与权限处理。
MinerU 不该只选一个后端:把 pipeline、VLM 与 hybrid 做成文档分流系统
MinerU 的生产价值在于按文档与页面难度分流,并用队列、幂等、版本化产物、质量指标、隐私和许可证治理把解析做成可运营系统。
SAG 不是又一个 RAG 变体:它在重建知识库的证据链
把文档切片、事件、实体和查询时动态超边结合起来,解决多跳检索里最容易断掉的证据链。
SAG 不是另一个向量库:它在重建知识库的证据链
SAG 的重点是把 Chunk、Entity、Event 和动态关系链结合起来,解决普通 RAG 多跳证据容易断的问题。
SAG 知识库要解决的是证据链,不是把答案写得更长
SAG、RAG、实体、事件和超边的差别,重点在证据如何组织、如何更新、如何被追溯。
OpenViking 长篇教程:给 AI Agent 建一个真正可用的上下文数据库
OpenViking 是面向 AI Agent 的 Context Database,用 viking:// 文件系统、L0/L1/L2 分层、MCP 和会话归档统一管理 memory、RAG、skills 与 sessions。
LiteParse:文档解析别一上来就烧云服务,先把本地入口做成可分流系统
LlamaIndex 团队开源的 LiteParse 适合把 RAG 文档解析前置层做成本地优先、带坐标、可复杂度检测、可分流的工程入口,而不是所有文件都直接送云端重解析。